Vektorová alebo relačná databáza: čo potrebujú vaše dáta
 Radovan Ďurčenka·· 3 min čítania
Stav objednávky, vyhľadávanie v dokumentoch a produktové filtre potrebujú odlišný prístup. Ako vybrať medzi SQL, fulltextom a vektormi.
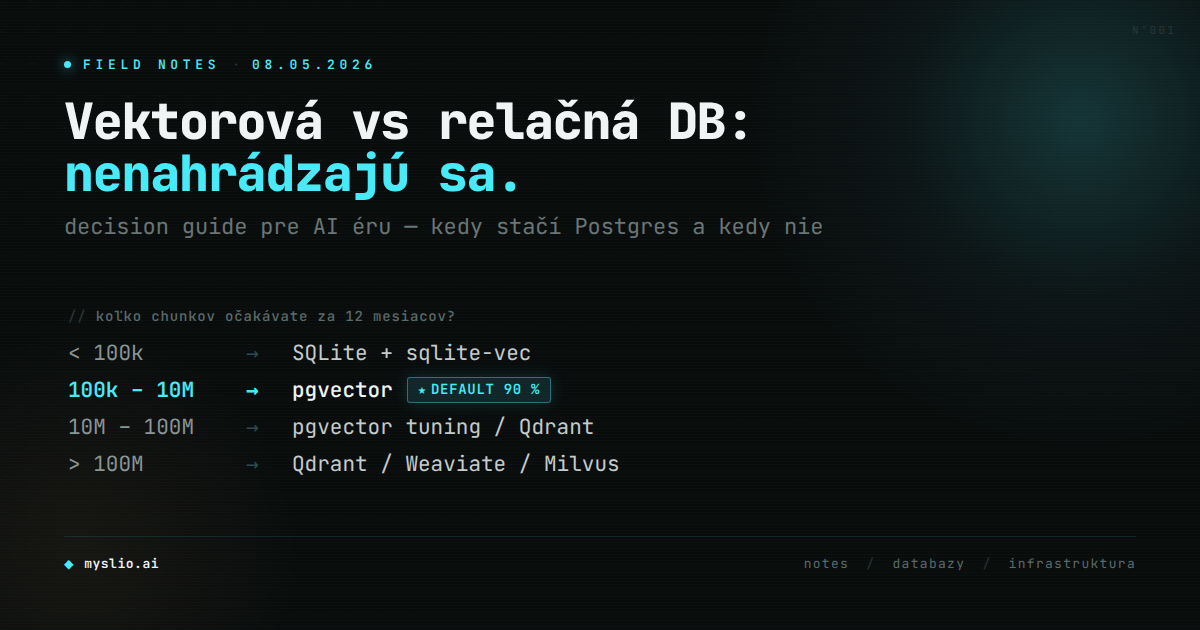
Presný stav objednávky a podobný text sú dve odlišné otázky
Keď sa zákazník pýta na svoju objednávku, potrebuje aktuálny záznam. Keď hľadá návod vlastnými slovami, potrebujeme nájsť relevantný text. Výber databázy by som začal týmto rozdielom.
Nasledujúce situácie sú modelové. Neslúžia ako tvrdenie o konkrétnom klientskom incidente ani ako výkonnostný benchmark.
Relačné údaje pre konkrétne fakty
Objednávky, faktúry, zásoby a platby majú identifikátory a vzťahy. Pri otázke na objednávku 2026/0042 potrebujete dohľadať túto objednávku v systéme, ktorý za jej stav zodpovedá. Sémanticky podobný dokument ju nenahradí.
V existujúcom riešení by som najprv overil dátový model, dotazy a indexy. Požiadavka na AI asistenta sama osebe neodôvodňuje migráciu fungujúcej databázy.
Fulltext pre slová a frázy
Pri hľadaní názvu produktu, označenia alebo frázy môže stačiť fulltext. Treba otestovať jazyk, skloňovanie a poradie výsledkov na reálnych dopytoch.
PostgreSQL má vlastné funkcie na spracovanie a hodnotenie textového vyhľadávania. Nie je presné stotožňovať jeho predvolené hodnotenie s BM25; dokumentácia PostgreSQL opisuje funkcie ts_rank a ts_rank_cd.
Vektory pre vyhľadávanie podľa podobnosti
Embedding prevedie obsah na číselnú reprezentáciu, ktorú možno porovnávať s inými vektormi. To pomáha pri hľadaní významovo príbuzných pasáží, aj keď otázka používa iné slová.
Podobnosť však nepotvrdzuje pravdivosť ani aktuálnosť dokumentu. Na výsledok vplýva model, rozdelenie textu a spôsob vyhľadávania. pgvector podporuje presné aj približné vyhľadávanie najbližších vektorov; približné indexy vymieňajú časť úplnosti výsledkov za rýchlosť.
Modelový príklad: asistent pre e-shop
Na otázku „Ako môžem vrátiť tovar?“ môže systém vyhľadať príslušný postup. Na otázku „Odišla už moja objednávka?“ musí po overení prístupu získať aktuálny stav objednávky.
Pri vyhľadávaní produktov sa môžu kombinovať textové výsledky, podobnosť a presné filtre. Cena či dostupná veľkosť musia zostať podmienkami výberu, nie iba súčasťou voľného textu.
Čo overiť pred nasadením
Vyberte reprezentatívne otázky a určte očakávané výsledky. Sledujte relevantnosť, aktuálnosť, odozvu a rešpektovanie prístupových práv. Zaznamenávajte aj prípady, pri ktorých správna odpoveď v podkladoch vôbec nie je.
Pri vektoroch ukladajte informáciu o modeli a zdrojovom dokumente. Zmenu modelu alebo spracovania textu overte na samostatnej sade dát pred prepnutím prevádzky. Pravidlá aktualizácie a mazania odvoďte od typu obsahu, nie od jedného univerzálneho počtu dní.
Kedy stačí PostgreSQL s pgvector
Ak už PostgreSQL prevádzkujete, stojí za to overiť vektorové vyhľadávanie v rovnakom prostredí. Môže zjednodušiť správu dát a prepojenie s bežnými záznamami.
Samostatný vyhľadávací systém posudzujte až podľa nameraných požiadaviek. Univerzálna hranica počtu dokumentov, pri ktorej treba migrovať, neexistuje. Rozhodujú aj rozmery vektorov, filtre, súbeh dotazov, pamäť, odozva a kvalita výsledkov.
Do porovnania nákladov zahrňte prevádzku, zálohy, obnovu, monitoring a čas tímu. Cena servera sama osebe nie je celkovou cenou riešenia.
Tri otázky pre váš projekt
- Potrebujete presný záznam, textovú zhodu alebo podobný obsah?
- Ktorý systém vlastní aktuálny údaj a kto k nemu smie pristupovať?
- Aký výsledok a odozvu musíte dosiahnuť na svojich dátach?
Ďalšie poznámky z praxe
Kedy Shoptet prestáva stačiť — a kedy ho určite nemeňte
Prevádzkujeme e-shopy na Shoptete aj na vlastnom commerce riešení. Keď e-commerce rastie, problém často vzniká až po nákupe: medzi skladom, fakturáciou, platbou, dopravcom a ľuďmi.
Kedy n8n, kedy Claude Desktop a kedy vlastný AI agent
Ako vybrať automatizáciu podľa úlohy, overiť jej výsledok a rozdeliť zodpovednosť medzi workflow, AI a človeka.